Нейросеть для озвучки текста: подготовка и проверка результата
Редакция MostAI9 мин
Обновлено
Чтобы озвучить русский текст нейросетью, выберите модель и голос, вставьте проверяемый фрагмент, посмотрите стоимость до запуска и прослушайте результат целиком. Особое внимание уделите числам, именам, сокращениям и отрицаниям: гладкая интонация не гарантирует, что смысл сохранился. Ниже — полный учебный пример с двумя записями. Автоматическая проверка позволяет сравнить распознанные слова, длительность и паузы; она не определяет, какая подача приятнее слушателю.
Как начать в MostAI
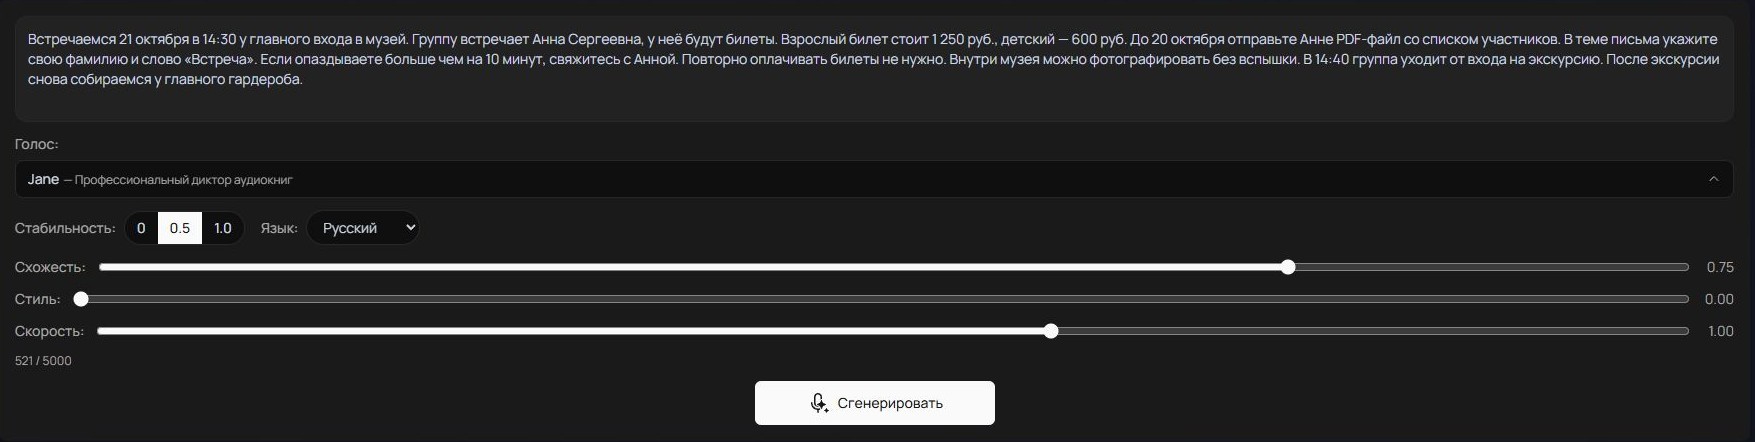
В генераторе голоса откройте ElevenLabs V3 в режиме «Диктор» для одного рассказчика. В интерфейсе, проверенном 20 октября 2026 года, доступны выбор голоса и настройки стабильности, сходства, стиля, скорости и языка. Для учебного сравнения выбран голос Jane, русский язык, stability 0,5, similarity 0,75, style 0 и speed 1. У обеих версий настройки одинаковы: меняется только подготовка текста. Это проверка двух конкретных входных вариантов, а не сравнение моделей или универсальное доказательство эффективности приёма.
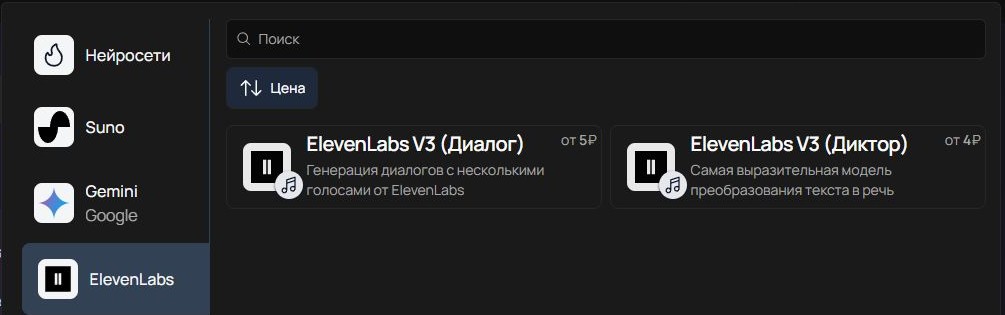
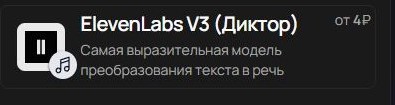
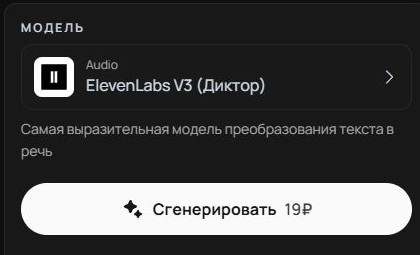
Шаг 1. Выберите модель. В НейроСтудии откройте «Аудио» → «ElevenLabs» → «ElevenLabs V3 (Диктор)». Карточка «Диалог» нужна для нескольких голосов. Надпись «от 4 ₽» в каталоге показывает стартовую цену, а не стоимость полного текста из примера.
Шаг 2. Вставьте текст и проверьте настройки. Для примера ниже в поле введён исходный вариант объявления; голос — Jane, стабильность — 0,5, язык — русский, сходство — 0,75, стиль — 0, скорость — 1. Перед новым запуском проверьте и эти значения, и сам текст: выбранная модель не исправит неверную дату или потерянное отрицание.
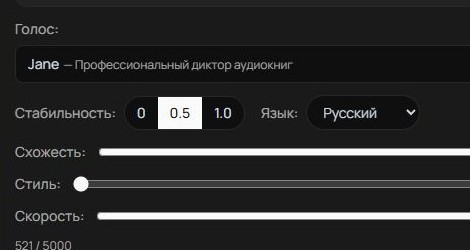
Стоимость зависит от текста и показывается до запуска. Для полных вариантов ниже интерфейс показал 19 ₽ и 22 ₽; столько же списано за два запуска 20 октября 2026 года, всего 41 ₽. Первая запись длится 41,28 секунды, вторая — 46,64 секунды. Это стоимость и длительность только этого опыта, а не обещание цены или скорости для другого текста. Повторных генераций не было.
Шаг 3. Посмотрите цену до генерации. На скриншоте показана цена 19 ₽ для исходного текста длиной 521 символ. Подготовленный вариант из 618 символов стоил 22 ₽. Нажатие «Сгенерировать» запускает платную запись; для этого примера обе записи уже сделаны и доступны ниже.
Для другого тембра можно отдельно попробовать Gemini TTS, но тогда это уже другой опыт: его результат нельзя приписывать настройкам ElevenLabs V3.
Подготовьте текст для слуха
Сначала прочитайте материал вслух. Разделите длинные предложения, уберите обороты, которые трудно понять на слух, и решите, как должны звучать даты, суммы и сокращения. Не меняйте смысл ради плавности. Если в тексте есть инструкция «не оплачивать», отрицание должно остаться и в подготовленном тексте, и в итоговом аудио.
Управление паузами зависит от конкретной модели и голоса. Пунктуация и разбиение на абзацы помогают задать ритм, но не дают пауз гарантированной длины. Официальная документация ElevenLabs прямо предупреждает, что Eleven v3 не поддерживает SSML-тег <break>; он относится к другим моделям. У v3 есть аудиотеги, однако их поведение нужно проверять на выбранном голосе. Справочник Eleven v4 описывает также возможности v4 — их нельзя автоматически переносить на v3 или считать доступными в интерфейсе MostAI. В этом примере специальные теги не применяются.
Учебный пример: исходный текст и подготовленная версия
Это вымышленное объявление о встрече в музее. Упомянутые мероприятие, билеты и цены не относятся к реальному событию. Обе версии передают одни и те же условия.
Вариант A — исходная запись:
Встречаемся 21 октября в 14:30 у главного входа в музей. Группу встречает Анна Сергеевна, у неё будут билеты. Взрослый билет стоит 1 250 руб., детский — 600 руб. До 20 октября отправьте Анне PDF-файл со списком участников. В теме письма укажите свою фамилию и слово «Встреча». Если опаздываете больше чем на 10 минут, свяжитесь с Анной. Повторно оплачивать билеты не нужно. Внутри музея можно фотографировать без вспышки. В 14:40 группа уходит от входа на экскурсию. После экскурсии снова собираемся у главного гардероба.
Вариант B — подготовка для чтения вслух:
Встречаемся двадцать первого октября в четырнадцать тридцать, у главного входа в музей.
Группу встречает Анна Сергеевна. У неё будут билеты. Взрослый билет стоит тысячу двести пятьдесят рублей. Детский стоит шестьсот рублей.
До двадцатого октября отправьте Анне пэ-дэ-эф файл со списком участников. В теме письма укажите свою фамилию и слово «Встреча».
Если опаздываете больше чем на десять минут, свяжитесь с Анной. Повторно оплачивать билеты не нужно.
Внутри музея можно фотографировать без вспышки. В четырнадцать сорок группа уходит от входа на экскурсию. После экскурсии снова собираемся у главного гардероба.
Написание «пэ-дэ-эф» задаёт выбранный способ произношения сокращения, а не единственно правильный. Здесь одновременно изменены числа, сокращение, длина предложений и абзацы, поэтому две полученные записи не показывают вклад каждого изменения по отдельности.
Что проверить после генерации
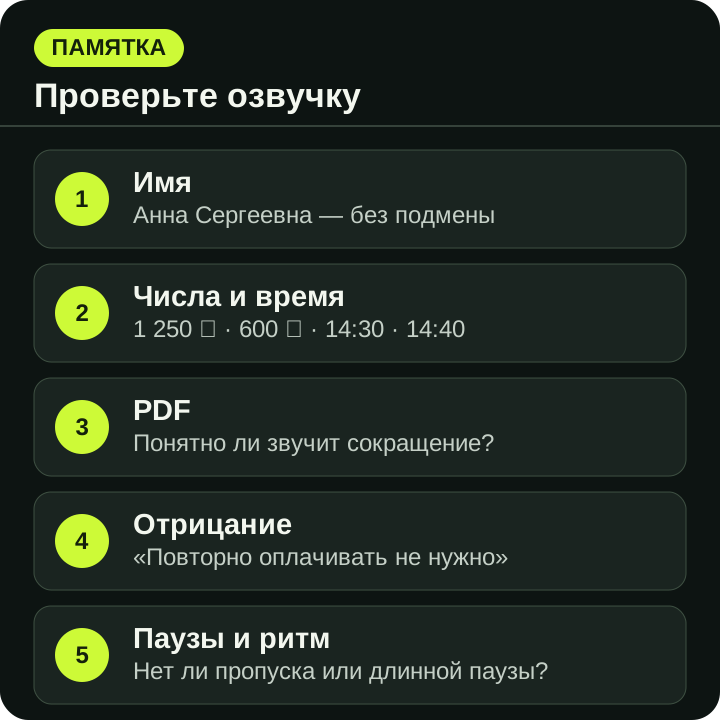
Прослушайте обе полные записи, не ограничиваясь автоматической расшифровкой. Отметьте фактическое произношение «Анна Сергеевна» и PDF, всех дат и сумм, времени 14:30 и 14:40. Проверьте слово «не» во фразе о повторной оплате, ограничение «без вспышки», письмо до 20 октября и встречу у главного гардероба. Отдельно оцените темп и паузы. Если модель пропустила или добавила условие, удачная интонация этого не исправляет.
| Критерий | Вариант A | Вариант B |
|---|---|---|
| Десять контрольных условий, включая имя, числа, PDF и «не нужно» | Найдены в автоматической расшифровке | Найдены в автоматической расшифровке |
| Паузы дольше 0,4 с при пороге −35 дБ | 7; суммарно 4,12 с | 10; суммарно 8,09 с |
| Прогноз естественности UTMOSv2, среднее по всем трёхсекундным окнам | 2,88; при сдвиге окон 2,81 | 2,68; при сдвиге окон 2,82 |
| Фактическая цена | 19 ₽ | 22 ₽ |
| Длительность файла | 41,28 с | 46,64 с |
Это две исходные записи без монтажа и третьих попыток. В обоих автоматических транскриптах найдены все десять заранее заданных контрольных условий, включая даты, суммы и отрицание. Во второй записи инструмент обнаружил больше длинных пауз, и она длится на 5,36 секунды дольше. Это измерение структуры файла, а не оценка естественности или правильности произношения. Распознавание может ошибаться: например, кавычки и прописная буква вокруг слова «письма» в одном транскрипте не доказывают различие в звучании. Прослушайте оба варианта, если точная дикция важна для вашей задачи.
Дополнительно мы оценили всю длину обеих записей через UTMOSv2 (откроется в новой вкладке) — автоматический оценщик естественности синтезированной речи. На основном разбиении исходная запись получила в среднем 2,88 балла по 14 трёхсекундным окнам, подготовленная — 2,68 по 16 окнам. Когда мы сдвинули границы окон на 1,5 секунды и снова покрыли всю запись, средние стали 2,81 по 15 окнам и 2,82 по 17 окнам соответственно. Это прогноз модели, а не оценки слушателей; окна частично перекрываются, а шкала не сверена с мнением русскоязычных слушателей для этого примера. Итог автоматической проверки: устойчивого преимущества по естественности ни у одной версии нет. Подготовка сохранила проверяемые условия и добавила паузы, но не показала надёжного выигрыша в естественности.
Если звучит не так
Если ошиблись дата или сумма, запишите их словами и ещё раз сравните с исходной инструкцией. Если фраза неразборчива, сократите её или измените разбиение на предложения. Если не подходит темп, попробуйте доступную настройку скорости, сохраняя остальные параметры и фиксируя новый запуск. Не объявляйте пунктуацию единственным средством управления голосом: в зависимости от модели доступны разные средства, и каждый результат нужно слушать.
Перед длинной записью полезно проверить самый сложный фрагмент: он быстрее выявит проблемы с именами и цифрами. Несколько проб стоят денег и времени, поэтому заранее посмотрите цену каждой в интерфейсе. Время полного цикла зависит от текста, числа исправлений и очереди генерации; фиксированных «полчаса» нет.
Частые вопросы
Можно ли вставить точную паузу?
В проверяемом здесь ElevenLabs V3 тег SSML <break> не поддерживается. Знаки препинания и абзацы могут влиять на ритм, но точную длительность не гарантируют. Для других моделей проверяйте их отдельную документацию и доступные настройки в MostAI.
Можно ли озвучить диалог?
В каталоге MostAI есть отдельный режим «Диалог» для нескольких голосов. Пример выше относится к режиму «Диктор» с одним голосом.
Нужно ли менять написание английских сокращений?
Только если конкретная запись произнесла сокращение неподходящим образом. Напишите желаемое произношение и прослушайте новый вариант; фонетическая запись тоже может дать нежелательный результат.
Можно ли клонировать голос в этом процессе?
Эта инструкция использует готовый голос Jane. Наличие функции клонирования в интерфейсе этого сценария не проверено, поэтому она здесь не обещается. Для использования чужого голоса нужно отдельное разрешение владельца.
Источники и история обновления
- ElevenLabs: рекомендации по синтезу речи (откроется в новой вкладке) — различия моделей, паузы и произношение, проверено 20 октября 2026 года.
- ElevenLabs: аудиотеги Eleven v3 (откроется в новой вкладке) — возможности v3; поддержка конкретного тега в MostAI требует проверки.
Материал впервые опубликован 14 июля 2026 года.
Озвучьте свою фразу сейчас
Вставьте текст в генератор голоса и подберите подачу — диктора или диалог. Не понравилось — перегенерируйте абзац, а не весь ролик.