Голоса-персонажи для мемов и скетчей: как задать ИИ-голосу характер
Маша Семёнова8 мин
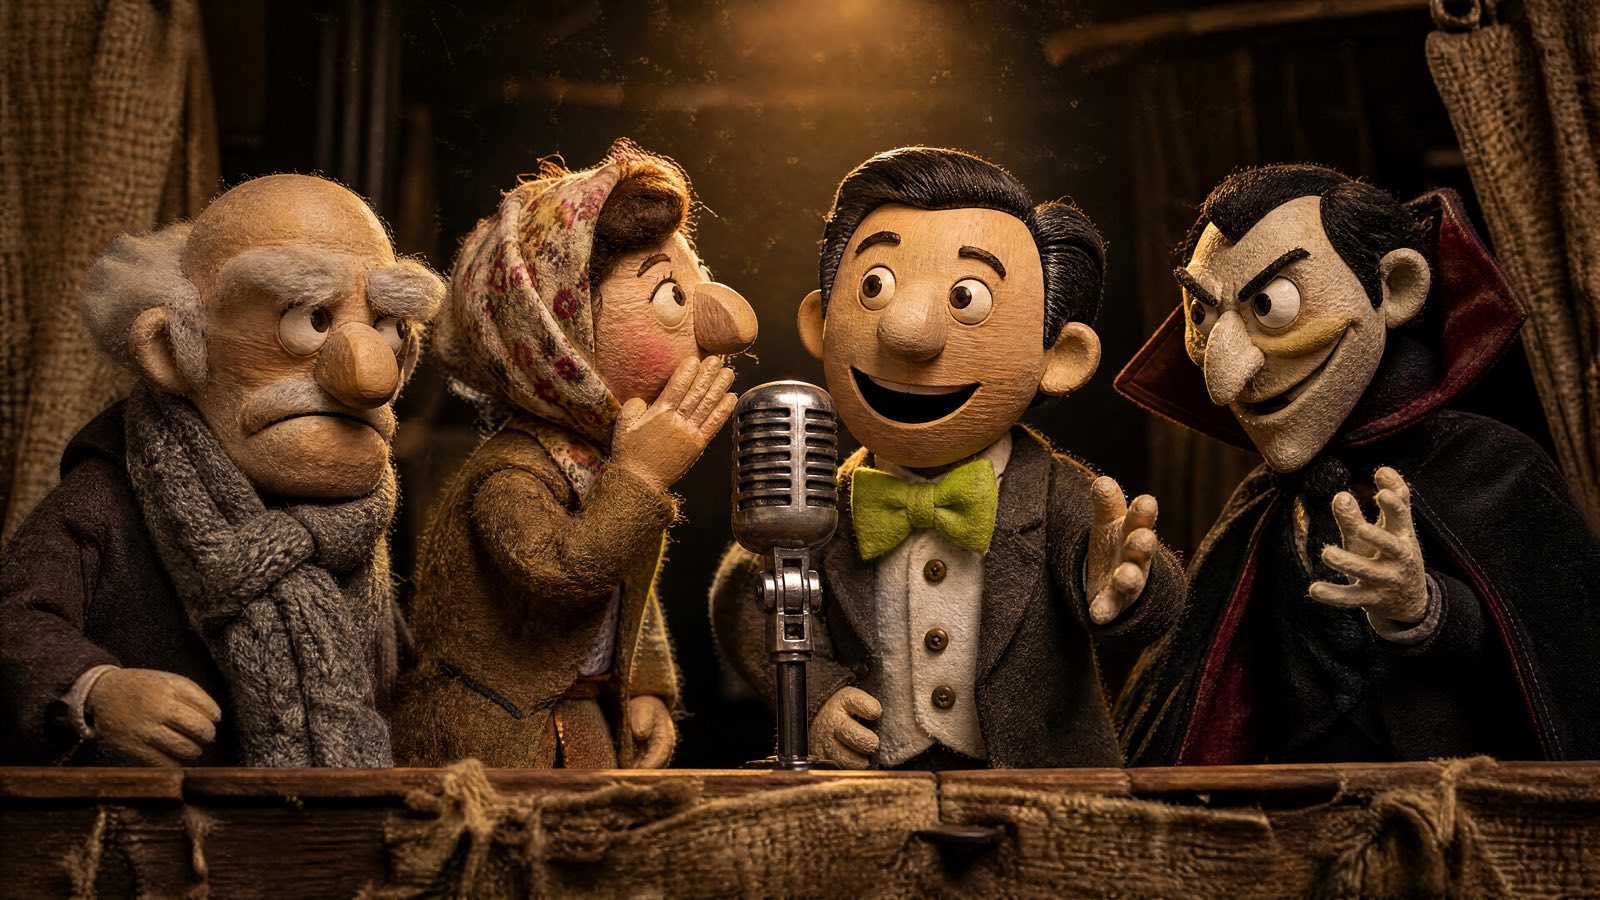
Чтобы у ИИ-голоса появился характер, одного удачного тембра мало. Персонажа собирают из трёх вещей: подходящего голоса, короткой ремарки о манере («ворчит», «шепчет с придыханием», «говорит как ведущий утреннего эфира») и текста, в котором герой говорит так, как говорил бы в жизни. Когда все три слоя совпадают, даже пятисекундная реплика звучит как маленькая роль, а не как чтение с листа. Ниже разберём четыре узнаваемых типажа, покажем, как задать их в ElevenLabs V3 и Gemini 3.1 TTS, и соберём сценку на двоих.
Чем персонаж отличается от просто голоса
Обычная озвучка старается быть незаметной: ровно, понятно, приятно. Персонаж наоборот должен быть заметным. Слушатель за пару секунд понимает, кто перед ним: старик, который всем недоволен, соседка, которая всё про всех знает, или ведущий, у которого даже прогноз погоды звучит как финал шоу.
Меня это когда-то удивило: узнаваемость почти никогда не держится на уникальном тембре. Она держится на манере: темпе, паузах, вздохах, любимых словечках, на том, где человек повышает голос, а где понижает. А манера как раз хорошо описывается словами, и современные голосовые модели её слышат.
Если вам нужен нарочито механический голос для мемов, это отдельная история, мы разбирали её в статье про роботный голос. Здесь речь о живых, человеческих характерах.
Три слоя характера
Порядок работы простой, но если его нарушить, придётся по многу раз перегенерировать одно и то же.
Слой первый — тембр. Это сам голос, который вы выбираете из списка. Низкий или высокий, мужской или женский, молодой или возрастной, с хрипотцой или звонкий. Тембр задаёт «кто это» в самом общем виде. Его подбирают один раз на персонажа и дальше не меняют.
Слой второй — манера. Как этот человек говорит прямо сейчас: устало, язвительно, взахлёб, шёпотом, с театральной паузой. Манера меняется от реплики к реплике, и именно её вы задаёте тегами и ремарками.
Слой третий — текст. Самый недооценённый. Ворчун не скажет «я испытываю лёгкое раздражение». Он скажет «ну конечно, опять». Если в тексте нет характера, никакой тег его не вытянет.
Четыре типажа и как их задать
Возьмём четыре героя, которые встречаются в скетчах чаще всего. Для каждого — что искать в тембре, как описать манеру и каким должен быть текст.
Ворчун
Тембр: низкий, чуть хрипловатый, возрастной. Манера: неторопливая, с тяжёлыми вздохами, с паузой перед главной претензией. Фразы короткие, часто начинаются с «ну», «вот», «опять».
[sighs] Ну конечно. Опять лифт не работает.
[pause] Двадцать лет живу в этом доме. [sighs] Двадцать лет.
И каждый раз одно и то же. [grumbling] Кто вообще придумал седьмой этаж?
Сплетница
Тембр: средний или высокий, живой, подвижный. Манера: быстрая, с переходом на заговорщический шёпот в самом интересном месте и с довольным смешком в конце. Текст полон «представляешь», «а она», «только никому».
[excited] Ты слышала? Нет, ты правда не слышала?
[whispers] Наша соседка сверху… купила второй холодильник.
[whispers] Второй! Зачем человеку два холодильника?
[giggles] Только никому, ладно?
Телеведущий
Тембр: поставленный, уверенный, скорее средний. Манера: бодрая, с подъёмом интонации к концу фразы, с широкими паузами, будто ждёт аплодисментов. Текст торжественный даже про ерунду.
[enthusiastic] Добрый вечер, дорогие зрители!
Сегодня в нашей студии — событие, которого вы так долго ждали.
[pause] Кот… наконец… слез со шкафа!
[excited] Встречайте!
Злодей
Тембр: низкий или, наоборот, слишком мягкий и вкрадчивый — оба варианта работают. Манера: медленная, с растянутыми словами и неприятно спокойной улыбкой в голосе. Текст вежливый, и от этого страшнее.
[calm] Вы съели последний сырник.
[pause] Я не сержусь. [softly] Совсем не сержусь.
[slow] Просто… запомните этот день.
[evil laugh]
Обратите внимание: во всех четырёх примерах теги только подсказывают манеру, а смешным или жутким реплику делает сам текст.
ElevenLabs V3: теги эмоций и режим Диалог
В каталоге Most AI есть ElevenLabs V3 в двух режимах: Диктор и Диалог. Для персонажей важно, что эта модель понимает теги в квадратных скобках прямо внутри текста. Тег ставится перед фразой или словом и меняет подачу именно этого кусочка: вздох, шёпот, смех, радость, сарказм.
Несколько практических советов по тегам.
- Пишите теги по-английски, короткими словами:
[sighs],[whispers],[laughs],[excited],[sarcastic]. Так модель понимает их надёжнее, чем длинные описания. - Не ставьте по три тега подряд на одну фразу. Один тег — одна смена настроения. Иначе модель начинает метаться, и характер размывается.
- Если тег проигнорирован, сначала поправьте текст. Шёпот лучше получается на короткой фразе с многоточием, чем на длинном сложном предложении.
- Паузу можно задать и тегом, и просто многоточием. Многоточие даёт более естественную заминку.
Режим Диалог будто придуман под скетчи. В нём вы пишете сцену по репликам и каждой назначаете своего спикера со своим голосом. Модель озвучивает всю сценку одним файлом, с естественными переходами между героями. Это удобнее, чем генерировать каждую реплику отдельно и потом стыковать их в монтажке: темп разговора получается живым, герои не говорят «в пустоту».
Режим Диктор пригодится, когда в сцене один персонаж: монолог ворчуна, закадровый голос ведущего, реплика злодея для мема.
Сценка на двоих: пример целиком
Соберём условную сценку «Ворчун и сплетница у подъезда». Сначала продумайте её на бумаге: кто начинает, где поворот, чем заканчивается. Скетч на тридцать секунд — это обычно шесть-восемь реплик, не больше.
Спикер 1 (ворчун): [sighs] Опять кто-то велосипед у двери поставил.
Спикер 2 (сплетница): [excited] А ты не знаешь чей? Я знаю!
Спикер 1 (ворчун): [grumbling] Ну и чей?
Спикер 2 (сплетница): [whispers] Из сорок второй квартиры. Там новый жилец… говорят, спортсмен.
Спикер 1 (ворчун): [sarcastic] Спортсмен. Поэтому велосипед на лестнице, а не под ним.
Спикер 2 (сплетница): [giggles] Вот и я говорю!
Спикер 1 (ворчун): [pause] [sighs] Я вообще-то ничего не говорил.
Подписи «Спикер 1 (ворчун)» здесь для наглядности: в генерацию идёт текст реплики с тегом, а голос вы назначаете спикеру.
Как с этим работать:
- Назначьте каждому спикеру голос, который вы заранее подобрали на пробных фразах. Контраст важен: если оба голоса похожи по высоте и темпу, слушатель будет путаться.
- Сгенерируйте сцену целиком и послушайте без текста перед глазами. Понятно ли, кто говорит? Слышен ли характер?
- Если одна реплика не получилась, правьте именно её: меняйте тег или переписывайте фразу. Остальное не трогайте.
- Когда сцена звучит, сохраните голоса и удачные теги в заметку. В следующем эпизоде герои должны звучать так же.
Если потом вы кладёте такую сценку на вертикальное видео, пригодятся советы из статьи про голос для вертикальных роликов: там про длину, склейки и субтитры.
Gemini 3.1 TTS: характер через ремарку
Gemini 3.1 TTS в каталоге работает в режиме Диктор, то есть озвучивает одного говорящего за раз. Характер здесь удобнее задавать не тегами, а обычной ремаркой на русском, как режиссёр объясняет актёру. Ремарку ставят перед текстом, она описывает, кто говорит и в каком состоянии.
Прочитай как пожилой ворчливый сосед, который устал и всем недоволен.
Говори медленно, с тяжёлыми вздохами, перед последней фразой сделай паузу.
Без крика — он не злится, он просто разочарован в жизни.

Опять лифт не работает. Двадцать лет живу в этом доме.
И каждый раз одно и то же.
Прочитай как ведущий вечернего шоу, торжественно и с огромным энтузиазмом.
Интонация идёт вверх к концу каждой фразы, перед главной новостью длинная пауза.

Добрый вечер, дорогие зрители! Сегодня в нашей студии событие года.
Кот наконец слез со шкафа!
После первой генерации проверьте, что модель не зачитала саму ремарку вслух. Если зачитала, сократите её и отделите от реплики пустой строкой или двоеточием.
Хорошая ремарка отвечает на три вопроса: кто этот человек, что он сейчас чувствует и чего в подаче быть не должно. Последний пункт часто забывают, а он помогает: «без крика», «без смеха», «не переигрывай».
Для сценки на двоих в Gemini озвучьте реплики каждого героя отдельными генерациями с одинаковой ремаркой, а затем склейте их в любом редакторе. Это чуть дольше, зато каждый персонаж под полным контролем.
Почему не копируем голоса реальных людей
Самая частая просьба в этой теме — «сделай голосом известного актёра» или «пусть говорит как наш начальник». Мы так не делаем, и дело не только в правилах.
Во-первых, голос — это часть личности человека. Использовать его без согласия — примерно то же самое, что взять чужое фото и выдать за своё. Даже в шутку это может обидеть, навредить репутации или ввести кого-то в заблуждение. Поэтому чужой голос — только с явного согласия его владельца. Клонирования голоса в каталоге Most AI нет.
Во-вторых, для скетча это и не нужно. Персонаж узнаётся по манере, а не по конкретному тембру. «Строгий начальник, который говорит короткими фразами и всегда смотрит на часы» — это смешно и узнаваемо, и при этом вы никого не копируете. Пародируйте типаж, а не человека.
Что чаще всего идёт не так
- Все персонажи звучат одинаково. Причина обычно в тексте: все реплики звучат одним и тем же языком. Дайте каждому герою свои словечки и свою длину фраз.
- Переигрывание. Слишком много тегов, восклицательных знаков и капса. Уберите половину — характер станет ярче, а не бледнее.
- Герой меняется от эпизода к эпизоду. Вы забыли, какой голос выбрали. Заведите на каждого персонажа карточку: голос и базовая ремарка.
- Длинные реплики. В скетче фраза длиннее двух строк теряет ритм. Режьте.
Про стоимость: в Most AI вы платите за генерацию, а не подпиской, и на подбор голосов уйдёт несколько попыток, так что заложите их заранее. Актуальные условия по голосовым моделям смотрите в прайсинге.
Частые вопросы
Какую модель выбрать для сценки на двоих?
Удобнее всего ElevenLabs V3 в режиме Диалог: вы назначаете каждой реплике своего спикера и получаете сцену одним файлом. Gemini 3.1 TTS тоже подойдёт, но реплики придётся генерировать по одной и склеивать самостоятельно.
Можно ли писать теги эмоций по-русски?
В ElevenLabs V3 надёжнее работают короткие английские теги вроде [sighs] или [whispers]. В Gemini 3.1 TTS, наоборот, удобно писать обычную ремарку на русском, как указание актёру. Сам текст реплик в обоих случаях может быть на русском.
Почему модель игнорирует мой тег?
Чаще всего тег конфликтует с текстом: например, шёпот на длинной фразе с восклицательными знаками. Упростите реплику, оставьте один тег на фразу и попробуйте ещё раз. Если не помогает, попробуйте другой голос: не каждый тембр одинаково хорошо шепчет или смеётся.
Можно ли сделать голос, похожий на известного человека?
Нет, и советуем даже не пытаться. Чужой голос без согласия владельца использовать нельзя, а клонирования голоса в каталоге нет. Для скетча достаточно узнаваемого типажа: манера, словечки и ситуация работают лучше, чем копия тембра.
Как сохранить одинаковый голос персонажа в разных роликах?
Заведите на каждого героя короткую карточку: какой голос вы выбрали и какой ремаркой или набором тегов описали его манеру. В следующий раз начинайте с этой заметки, а не с нуля. Так ворчун из первой серии будет звучать так же и в десятой.
Сколько реплик должно быть в коротком скетче?
Для ролика на полминуты обычно хватает шести-восьми коротких реплик. Важнее не количество, а ритм: завязка, поворот и последняя фраза, ради которой всё затевалось. Если сцена затягивается, режьте середину, а не финал.
Персонаж для мема или скетча — это маленькая роль, и собирается она так же, как в театре: подходящий голос, понятная задача и живой текст. Начните с одного героя и одной фразы, найдите его манеру, а потом добавьте ему собеседника.
Озвучьте свою фразу сейчас
Вставьте текст в генератор голоса и подберите подачу — диктора или диалог. Не понравилось — перегенерируйте абзац, а не весь ролик.