Как нейросеть делает картинку и видео из шума: объяснение без формул
Маша Семёнова9 мин
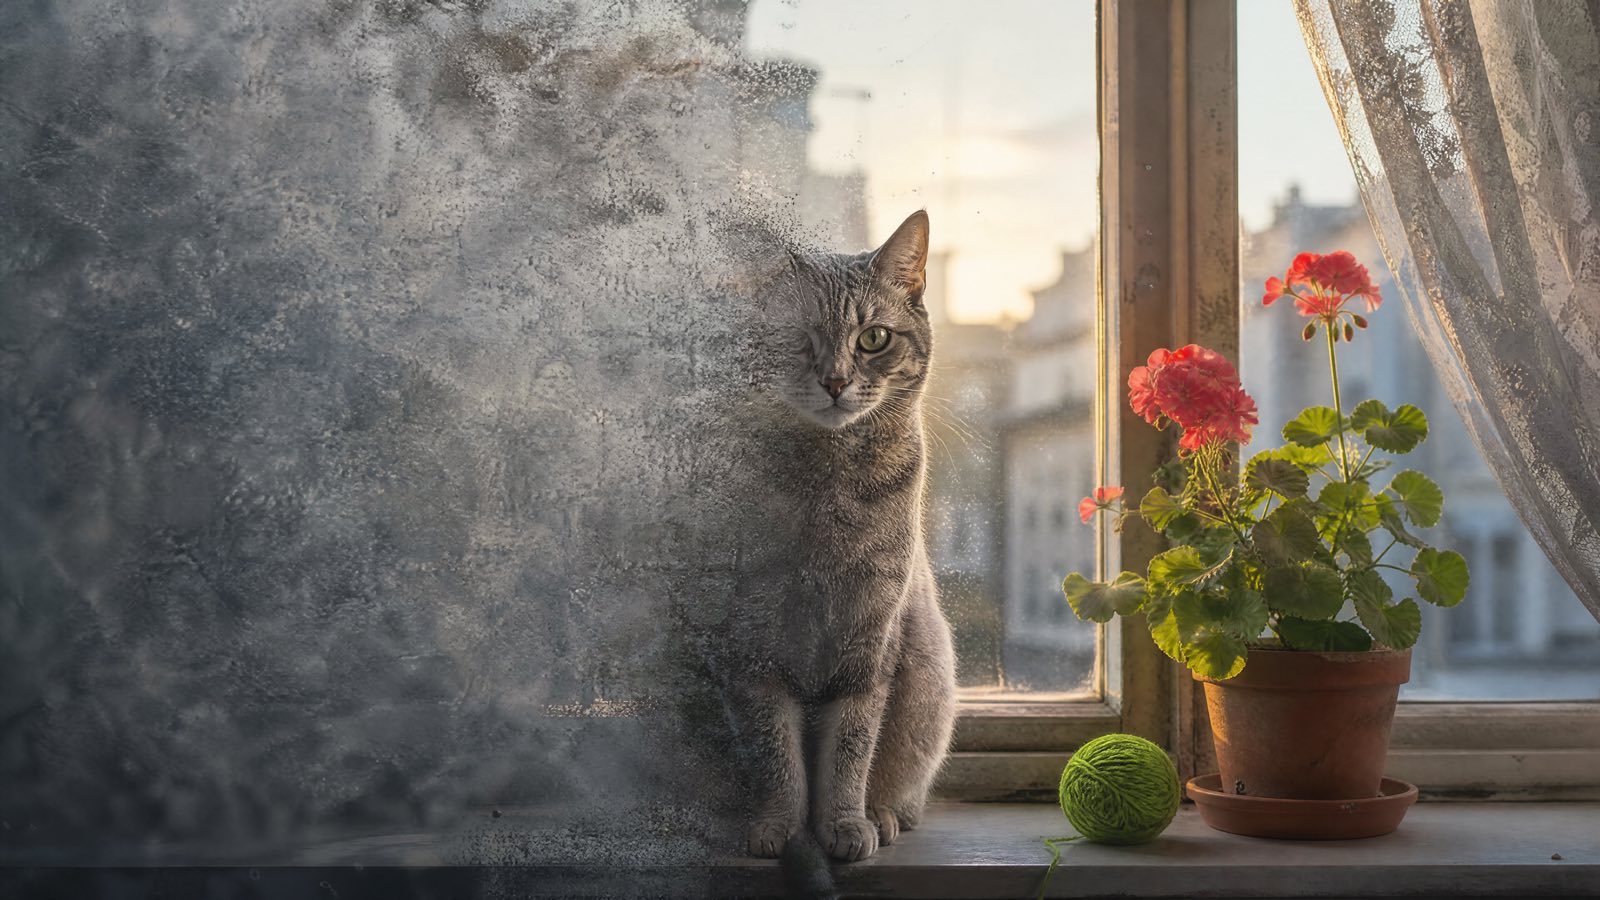
Нейросеть делает картинку и видео не так, как художник, который рисует линию за линией. Она начинает с цифрового шума — экрана, похожего на помехи старого телевизора, — и за много коротких шагов убирает из него всё, что не похоже на описание из промта. У картинки это один кадр, у видео — целая пачка кадров, которые нужно «очистить» одновременно и согласованно. Отсюда и ожидание в несколько минут, и короткая длина роликов, и знаменитые плывущие пальцы. Ниже разберём каждую из этих странностей на бытовых примерах и сразу скажем, что с ней делать на практике.
Если вы вообще впервые слышите, как устроены нейросети, сначала загляните в наш простой рассказ о нейросетях. Здесь речь только о том, как они рисуют и снимают.
Скульптор, который работает с туманом
Представьте скульптора, которому дали не мрамор, а облако тумана. Ему говорят: «Здесь должна быть кошка на подоконнике». Он не лепит кошку с нуля. Он смотрит на туман и думает: «Вот это пятно слегка похоже на ухо, уберу вокруг лишнее». Потом ещё раз: «А тут, кажется, окно». Шаг за шагом из хаоса проступает сцена.
Примерно так работает генерация. Во время обучения модель посмотрела огромное количество картинок и видео, которые специально портили шумом, и училась обратному: по зашумлённому кадру угадывать, как выглядел чистый. Когда вы пишете промт, модель берёт свежий случайный шум и много раз подряд делает одно и то же движение — чуть-чуть очищает, сверяясь с вашим описанием.
Из этого сразу следуют две вещи, полезные в жизни:
- Один и тот же промт даёт разные результаты. Стартовый шум каждый раз новый, поэтому и кошка каждый раз немного другая. Это не ошибка, а свойство метода. Две-три попытки на одну идею — нормальная практика.
- Модель не знает мир, она знает, как мир обычно выглядит. Она не понимает, что у человека пять пальцев. Она видела много рук и помнит, что «рука обычно выглядит вот так». Если рука в кадре мелкая, повёрнута или частично закрыта, «обычно» размывается — и пальцев становится то четыре, то шесть.
Почему видео считается минутами, а картинка — секундами
Картинка — это один кадр. Видео — это десятки кадров на каждую секунду, и все они должны быть про одно и то же: один и тот же герой, та же комната, тот же свет. Нельзя очистить первый кадр, потом отдельно второй — выйдет мельтешение, где лицо меняется каждое мгновение.
Поэтому видеомодель очищает весь ролик разом, как будто это одна большая объёмная картинка, где кроме ширины и высоты есть ещё время. Представьте, что скульптор теперь работает не с облаком, а с длинным туннелем тумана, и в каждом сантиметре туннеля кошка должна быть той же самой кошкой, только чуть сдвинутой.
Вот откуда берутся минуты ожидания. Каждая лишняя секунда ролика и каждая ступенька разрешения прибавляют работы на каждом шаге очистки. Поэтому:
- 5 секунд обычно готовы быстрее, чем 10;
- вариант в 4K считается дольше, чем в 720p;
- версии со словами «Fast» и «Mini» в названии задуманы как более быстрые и бюджетные, ими удобно прикидывать идею.
На практике это значит: пробуйте идею в коротком и недорогом варианте, а длинный и чёткий ролик запускайте, когда сцена уже понравилась.
Почему ролики такие короткие
Та же причина, только с другой стороны. Модель держит в памяти весь отрезок целиком. Чем он длиннее, тем сложнее сохранить героя одинаковым от первого до последнего кадра. Поэтому большинство моделей выдают ролики длиной в несколько секунд, а максимум у каждой свой. Например, у Sora 2 это от 4 до 12 секунд, у Veo 3.1 Fast Relax — 8 секунд, у Grok Video — до 30.
Длинный фильм нейросеть не снимает одним куском. Его собирают из коротких планов, как собирают клип из отдельных дублей. Минутный ролик — это несколько, а то и десяток генераций плюс монтаж.
Откуда в ролике берётся звук
Раньше видеомодели выдавали немое кино, а звук добавляли отдельно. Сейчас многие модели умеют генерировать картинку и звук вместе: шаги, шум улицы, музыку, даже реплику героя. В каталоге Most AI со звуком работают, например, Kling 3.0, Seedance 2.5 и Veo 3.1 Fast, причём у Veo 3.1 Fast есть русская озвучка.
Как это устроено, если без формул: модель училась на видео, где картинка и звук идут вместе. Она запомнила, что хлопок двери звучит в тот момент, когда дверь закрывается, а губы двигаются под слова. Поэтому звук появляется из того же «тумана», что и картинка, и подгоняется под действие.
Что это значит для вас:
- Если нужен звук, опишите его в промте. «Слышно, как дождь стучит по стеклу» работает лучше, чем надеяться, что модель догадается.
- Реплику пишите коротко. Длинная фраза не уместится в несколько секунд и зазвучит скомканно.
- Если нужен точный текст или спокойный дикторский голос, делайте звук отдельно. Готовое видео можно озвучить голосовой моделью, например ElevenLabs V3 в режиме диктора.
Текст-в-видео и фото-в-видео: в чём разница
Это самый важный для новичка выбор. Я всегда объясняю его на том же скульпторе с туманом, так проще всего.
Текст-в-видео. Вы даёте только описание. Модель сама решает, как выглядит герой, какая комната, какой свет. Свободы много, контроля мало. Каждая попытка — новый герой.
Фото-в-видео. Вы даёте готовый кадр, а модель добавляет ему движение. Это как если бы скульптору дали уже вылепленную кошку и попросили только сделать так, чтобы она повернула голову. Лицо, одежда, фон уже заданы, и модели не нужно их придумывать. Такой режим в каталоге собран в разделе оживления картинки в видео.
Проще всего запомнить так:
| Что у вас есть | Что выбрать | Чего ждать |
|---|---|---|
| Только идея, внешность не важна | Текст-в-видео | Быстро пробовать, но герой каждый раз разный |
| Нужен конкретный герой или товар | Фото-в-видео | Внешность держится, модель добавляет только движение |
| Кадра ещё нет, но нужен контроль | Сначала картинка, потом фото-в-видео | Два шага, зато предсказуемо |
Третья строка — самый частый путь у тех, кто уже немного освоился. Сначала рисуете кадр картиночной моделью, например Nano Banana 2, добиваетесь, чтобы он нравился, и только потом оживляете его в Kling 3.0 или Seedance 2.5.
Зачем нужен референс
Референс — это картинка-подсказка, которую вы прикладываете к запросу. Для модели это якорь в тумане: «вот так должен выглядеть герой, от этого и отталкивайся».
Вернёмся к пальцам. Когда модель придумывает руку сама, у неё есть только расплывчатое «обычно рука выглядит так». Когда в исходном кадре рука уже нарисована чётко, модели остаётся лишь сдвинуть её, и шансов на лишний палец гораздо меньше. То же с лицом: без опоры оно «плывёт» между кадрами, с опорой держится.
Важная оговорка: референсом может быть ваше фото или рисунок. Чужие фотографии используйте только с согласия человека, который на них изображён. И не пытайтесь сделать копию знаменитости: это чужое лицо и чужие права, такие ролики легко принять за настоящие.
Почему плывут пальцы, текст и мелкие детали
Соберём всё вместе. Модель ошибается там, где у неё мало опоры и много вариантов:
- Руки и пальцы. Сложная форма, много положений, часто в движении.
- Надписи. Буквы для модели — узор, а не слова. Короткое крупное слово получится, абзац на вывеске скорее всего нет.
- Быстрое сложное движение. Кувырок, танец, драка — каждый кадр сильно отличается от соседнего, и согласовать их труднее.
- Много людей в кадре. Чем больше героев, тем выше шанс, что кто-то перепутается.
Что помогает: крупный план вместо общего, одно понятное действие вместо трёх, спокойная камера, чёткий исходный кадр. Если ролик всё равно вышел странным, загляните в разбор частых сбоев видеогенерации — там собраны типичные поломки и способы их чинить.
Как принципы превращаются в промт
Теперь, зная, как работает модель, промт писать проще. Ей нужно понять, что оставить в тумане: кто в кадре, что делает, где, какая камера и какой звук. Вот пример для текст-в-видео:
Рыжая кошка сидит на подоконнике и смотрит на дождь за окном.
Она медленно поворачивает голову к зрителю и моргает.
Уютная комната, тёплый свет лампы, за стеклом вечерний город.
Камера стоит неподвижно, крупный план.
Звук: дождь стучит по стеклу, тихо тикают часы.
А это пример для фото-в-видео, когда кадр у вас уже есть. Внешность описывать не нужно, она на картинке. Описываем только движение:
Девушка на фото поднимает чашку и делает глоток,
потом улыбается и смотрит в окно.
Волосы слегка шевелятся от ветра.
Камера медленно приближается.
Обратите внимание: в обоих промтах одно главное действие, спокойная камера и никаких мелких надписей. Это прямое следствие всего, о чём мы говорили выше.
Первая проба: Seedance 2 Mini
Для первого знакомства берите не флагман, а быструю и бюджетную модель. В каталоге Most AI это Seedance 2 Mini. Цель первой пробы — не шедевр, а почувствовать, как модель откликается на слова.
Условный сценарий на вечер:
- Войдите в кабинет через Яндекс или VK и откройте раздел с видеомоделями.
- Выберите Seedance 2 Mini, режим текст-в-видео, короткую длительность.
- Вставьте промт про кошку из примера выше и запустите.
- Запустите тот же промт ещё раз и сравните: увидите, как новый стартовый шум даёт другую кошку.
- Поменяйте одну деталь — например, «камера медленно облетает кошку» — и посмотрите, что изменилось.
- Когда сцена понравится, повторите её в более сильной модели: Kling 3.0 или Seedance 2.5.
Стоимость каждой генерации зависит от модели, длины и разрешения, актуальные цены смотрите в прайсинге. Платите за генерации, подписки нет.
Частые вопросы
Почему один и тот же промт даёт разные видео?
Каждая генерация начинается с нового случайного шума. Модель очищает его по вашему описанию, но стартовая точка всегда другая, поэтому и результат разный. Если нужно повторяемое, опирайтесь на исходную картинку в режиме фото-в-видео.
Можно ли сделать минутный ролик за одну генерацию?
Обычно нет. Большинство моделей выдают отрезки в несколько секунд, самые длинные — до полуминуты. Длинное видео собирают из коротких планов и склеивают в монтажной программе.
Нейросеть понимает, что она рисует?
Не так, как человек. Она помнит, как вещи обычно выглядят и двигаются, но не знает, что у руки пять пальцев или что чашка не проходит сквозь стол. Поэтому ошибки случаются именно в деталях, которые трудно угадать по «обычно».
Промт писать по-русски или по-английски?
Многие модели в каталоге понимают русский, например Seedance 2.5 и MiniMax H3. Пишите по-русски простыми фразами. Если результат не слушается, попробуйте тот же текст по-английски и сравните.
Что выбрать новичку: текст-в-видео или фото-в-видео?
Для первых проб подойдёт текст-в-видео: так быстрее увидеть, как модель реагирует на слова. Когда нужен конкретный герой, товар или ваше фото, переходите на фото-в-видео — внешность держится заметно лучше.
Почему звук иногда не совпадает с картинкой?
Модель генерирует звук вместе с изображением и подгоняет его на глаз, а не по точной разметке. Длинная реплика или сложное действие легко «съезжают». Сократите фразу, опишите звук явно или озвучьте готовое видео отдельно.
Если запомнить из этой статьи одно, то вот что: нейросеть не снимает кино, а проявляет его из шума, и держится лучше там, где вы дали ей опору. Короткий план, одно действие, понятная камера и готовый кадр на входе — и результат станет гораздо предсказуемее.
Осталось собрать на своём кадре
Повторите разобранное в кабинете: приложите фото или опишите сцену — и получите готовый ролик без монтажной программы.