Токены простыми словами: как считать текст и не путать лимиты
Редакция MostAI8 мин
Обновлено
Токен — фрагмент, на который модель разбивает входной текст и из которого строит ответ. Это может быть слово, часть слова, знак препинания или сочетание пробела с буквами. Число токенов зависит от конкретного токенизатора и текста. Универсального пересчёта «столько-то русских слов = один токен» нет. Пользователю важнее различать три вещи: сколько помещается в контекст, сколько модель может написать за ответ и сколько обращений разрешает сам сервис.
Что такое токен на пальцах
Представьте, что модель не умеет читать буквы. Вместо этого у неё есть словарь из нескольких десятков или сотен тысяч фрагментов текста, и любую фразу она собирает из них, как из кубиков. Частые куски — например, распространённые слова целиком — лежат в словаре одним кубиком. Редкие слова приходится собирать из нескольких мелких.
Этот словарь и правила нарезки называются токенизатором. Одна фраза в разных кодировках может занять разное число токенов. Если кодировка известна, точное разбиение видимого текста можно воспроизвести внешней программой; полный объём обращения в конкретном сервисе может дополнительно включать историю, служебные инструкции и вложения.
Проверенный пример: одна задача, две кодировки
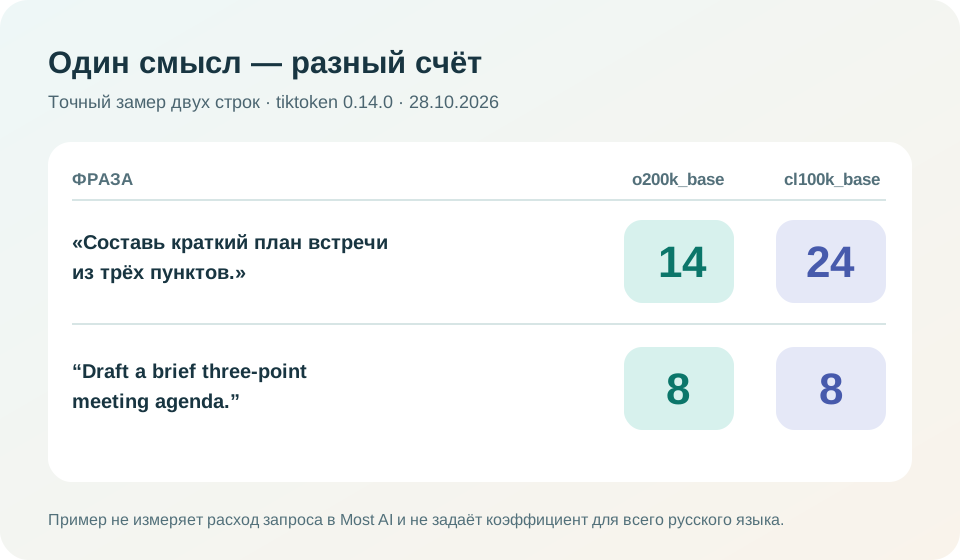
28 октября 2026 года мы прогнали две короткие фразы через открытую библиотеку tiktoken от OpenAI (откроется в новой вкладке), версия 0.14.0, без вызова платной модели. Сравниваем похожие по смыслу запросы, но это не буквальный перевод слово в слово.
| Фраза | o200k_base |
cl100k_base |
|---|---|---|
| «Составь краткий план встречи из трёх пунктов.» | 14 | 24 |
| “Draft a brief three-point meeting agenda.” | 8 | 8 |
Числа можно воспроизвести локально после установки tiktoken. В код передаётся сама фраза без декоративных кавычек из таблицы:
import tiktoken

phrase = "Составь краткий план встречи из трёх пунктов."
for name in ("o200k_base", "cl100k_base"):
    print(name, len(tiktoken.get_encoding(name).encode(phrase)))
Для русской строки код выведет o200k_base 14 и cl100k_base 24. Для английской строки замените значение phrase на Draft a brief three-point meeting agenda. — получите 8 в обеих кодировках. Замер относится только к этим строкам и кодировкам. Это не фактический расход обращения в Most AI и не универсальное отношение русского языка к английскому. Для другого текста или модели числа меняются. Менять точную русскую инструкцию на неточный перевод ради гипотетической экономии не стоит.
Почему число токенов меняется
Разные токенизаторы используют разные словари фрагментов. Частые для одного словаря сочетания могут быть одним токеном, а для другого — несколькими. В русских текстах падежные формы, редкие слова, смешение кириллицы с латиницей и цифрами тоже меняют разбиение. Никакой фиксированный множитель для всех русских запросов отсюда не следует: проверяйте свой текст и кодировку, если точное число действительно важно.
На что влияют токены
Для пользователя токены важны в трёх местах: доступный объём, длина ответа и тарификация. Эти ограничения могут задаваться разными правилами.
Лимит контекста
Контекст — данные, доступные модели в одном обращении: текущий вопрос, переданные материалы, доступная часть истории и место под ответ. У модели есть предел контекстного окна; сам сервис может дополнительно ограничивать размер файла или отдельного сообщения.
Когда объём превышает предел, сервис может отказать в обработке, обрезать или сжать часть материала. Если старые сведения перестали учитываться, нельзя по одному симптому доказать, что именно произошло: возможна и обычная ошибка ответа. Подробности — в статье о длинном контексте.
Длина ответа и ожидание
Модель формирует ответ последовательно. Более длинный ответ обычно требует больше выходных токенов и времени. Но задержка может быть вызвана и обработкой файла, вызовом инструмента или нагрузкой сервиса; по одному времени ожидания нельзя определить расход токенов.
Максимальная длина ответа — отдельный предел. Даже если исходный документ поместился, это не обещание, что модель выдаст книгу за одно сообщение. Для большой работы просите результат частями.
Цена запроса
У платных текстовых моделей входные и выходные токены могут учитываться и оцениваться отдельно. Вложения, инструменты и отдельные режимы тоже могут иметь свои правила. Внешний токенизатор не заменяет фактическую сумму на платформе. Актуальную стоимость и доступный режим проверяйте на странице тарифов и в интерфейсе выбранной модели перед запуском. Не делайте вывод о бесплатности или числе обращений из одного лишь размера контекстного окна.
Лимит сообщений — другое правило
Сервис может ограничить количество запросов за период, доступ к модели или отдельный инструмент. Это не то же самое, что контекст или максимум токенов в ответе. Если интерфейс сообщает о лимите сообщений, сокращённый промт не обязательно поможет: проверьте условия именно этого режима.
| Ограничение | Что означает | Что попробовать |
|---|---|---|
| Контекстное окно | Сколько материала доступно в одном обращении | Убрать не относящуюся к задаче историю и вложения |
| Длина ответа | Сколько текста модель может выдать за раз | Сузить задачу или попросить результат частями |
| Лимит сообщений | Сколько обращений разрешает сервис | Проверить условия доступа и время восстановления |
Как прикинуть объём без калькулятора
При известном токенизаторе видимый текст можно посчитать точно. Для обычного запроса практичнее сначала убрать шум, сохранив важные условия.
- Смотрите на задачу, а не на число страниц. Один нужный пункт договора полезнее сорока страниц приложений, если вопрос только о нём.
- Учитывайте историю. Длинный диалог может увеличивать передаваемый контекст, но конкретный способ обработки истории зависит от сервиса.
- Оставляйте место для ответа. Развёрнутый результат тоже требует доступного объёма и может упереться в отдельный предел вывода.
Если модель путает ранние факты, повторите нужные исходные данные. Ошибка сама по себе не доказывает, что история «вытеснилась».
Как сократить лишнее в запросе
Сокращайте не смысл, а лишнее. Короткий запрос с пропущенным условием способен ухудшить ответ сильнее, чем длинный с полной задачей.
Давайте выдержку, а не весь документ
Если вопрос про одну главу, вставьте одну главу. Методичка на сотню страниц ради одного параграфа — это лишний объём, в котором модели придётся искать нужное.
Например, если в договоре пункт 3.2 обещает поставку за 10 рабочих дней, а приложение А — за 14 календарных дней, передайте обе точные цитаты с номерами. Попросите сопоставить сроки с учётом начальной даты, календаря и правил приоритета документов: без этих данных нельзя утверждать, что сроки противоречат друг другу. Удаление одного из пунктов ради экономии токенов разрушит саму задачу; применимый срок сверяют с оригиналом и специалистом.
Уберите повторы и обёртки
Необязательное вступление увеличивает объём запроса. Вежливость не мешает, но повтор одного условия разными словами может отвлечь от задачи. Сравните:
Здравствуйте! Я студент второго курса, у меня есть задание по истории,
его нужно сдать в пятницу, и я не очень понимаю, как его сделать.
Нужно сделать про реформы, реформы Александра II, их было несколько,
и надо рассказать про них, но не слишком длинно, потому что
преподаватель не любит длинные тексты, лучше коротко.
Задача: краткий обзор реформ Александра II для студента 2 курса.
Срок сдачи: пятница.
Формат: 5 пунктов, по 2-3 предложения на реформу.
Для каждой: суть, год, главное последствие.
Второй вариант точнее задаёт формат, но если преподаватель дал критерии или список источников, их тоже нужно передать.
Просите нужную длину ответа
Ответ тоже состоит из токенов, и по умолчанию модели склонны к развёрнутым текстам. Если вам нужен список из пяти пунктов, так и скажите в запросе. Это ускоряет ответ и уменьшает объём, который придётся читать и проверять.
Начинайте новый чат при смене темы
Закончили с рефератом и перешли к статистике — новый диалог поможет отделить другую задачу. Как именно сервис передаёт прежнюю историю модели, зависит от его устройства.
Сжимайте длинный диалог
Если разговор важный, попросите выжимку и сверьте её с исходными документами, прежде чем перенести в новый чат.
Сделай сжатую выжимку нашего диалога для продолжения в новом чате.
Включи: тему работы, принятые решения, требования преподавателя,
что уже готово и что осталось сделать.
Без пересказа обсуждений, только итоги. Не больше 15 строк.
Английский промт — только когда это оправдано
Иногда советуют писать по-английски ради экономии. Она возможна в некоторых кодировках и на некоторых текстах, но не гарантирована. Потеря нюанса в переводе способна испортить результат. Если много раз используете один шаблон, измерьте обе версии на подходящем токенизаторе и сравните качество ответа. В остальных случаях пишите на языке, на котором формулируете задачу точнее.
| Что тратит токены | Что сделать |
|---|---|
| Документ целиком ради одного вопроса | Вставить только нужный фрагмент |
| Повторы условия разными словами | Сформулировать задачу один раз, по пунктам |
| Длинная история чата на другую тему | Открыть новый диалог |
| Развёрнутый ответ, когда нужен список | Указать формат и длину ответа |
Если в словах вроде «контекст», «промт» или «модель» ещё путаетесь, загляните в словарь терминов для новичка — там основные понятия собраны на одной странице.
Частые вопросы
Один токен — это одно слово?
Не всегда. Слово может разбиться на несколько фрагментов, а знак препинания или пробел — войти в отдельный либо соседний фрагмент. Точное число зависит от кодировки; нельзя обещать, что оно всегда больше числа слов.
Почему одна и та же фраза у разных моделей занимает разное число токенов?
Разные модели могут использовать разные токенизаторы, то есть словари кусочков текста. То, что одна кодировка считает одним фрагментом, другая может разбить на несколько. Сравнивать лимиты моделей по одному пересчёту слов можно лишь приблизительно.
Русский текст всегда обходится дороже английского?
Нет универсального правила для каждой модели и пары фраз. В нашем коротком примере русский запрос занял больше токенов, но это две конкретные кодировки и два текста. Фактическая стоимость зависит ещё и от тарифа и полного объёма обращения. Смотрите условия выбранной модели.
Что будет, если текст не поместится в контекст?
Поведение зависит от сервиса: он может отказать в обработке, сократить доступный материал или предложить разбить задачу. Разделите документ по смысловым частям и сохраните связи между ними, если ответ требует сопоставления.
Влияет ли вежливость в запросе на расход токенов?
Формально да, каждое слово стоит токенов, но пара вежливых фраз — ничтожная доля запроса. Гораздо больше тратят повторы условия, лишние вложения и долгая история чата. Убирать стоит именно их.
Нужно ли новичку считать токены вручную?
Нет. Достаточно отличать контекст, ответ и лимит сообщений. Если модель теряет важные детали, повторите нужные факты и проверьте результат; если сервис прямо сообщает о лимите, следуйте его условиям. Точный подсчёт нужен для повторяемого процесса с жёстким бюджетом или объёмом.
Токены помогают оценить объём текста, но не заменяют проверку условий сервиса и качества ответа. Дайте модели нужный фрагмент, сохраните все существенные ограничения и задайте требуемый формат; точное число проверяйте на токенизаторе конкретной модели, когда оно действительно влияет на решение.
Повторите на своём материале
Зарегистрируйтесь и сделайте разобранное сами: чат ChatGPT бесплатен, остальные модели — с оплатой в рублях за генерацию, без подписки.